노드
전체 클러스터에서 오퍼레이터가 보고하는 모든 노드 목록을 조회하고 관리하는 화면입니다.
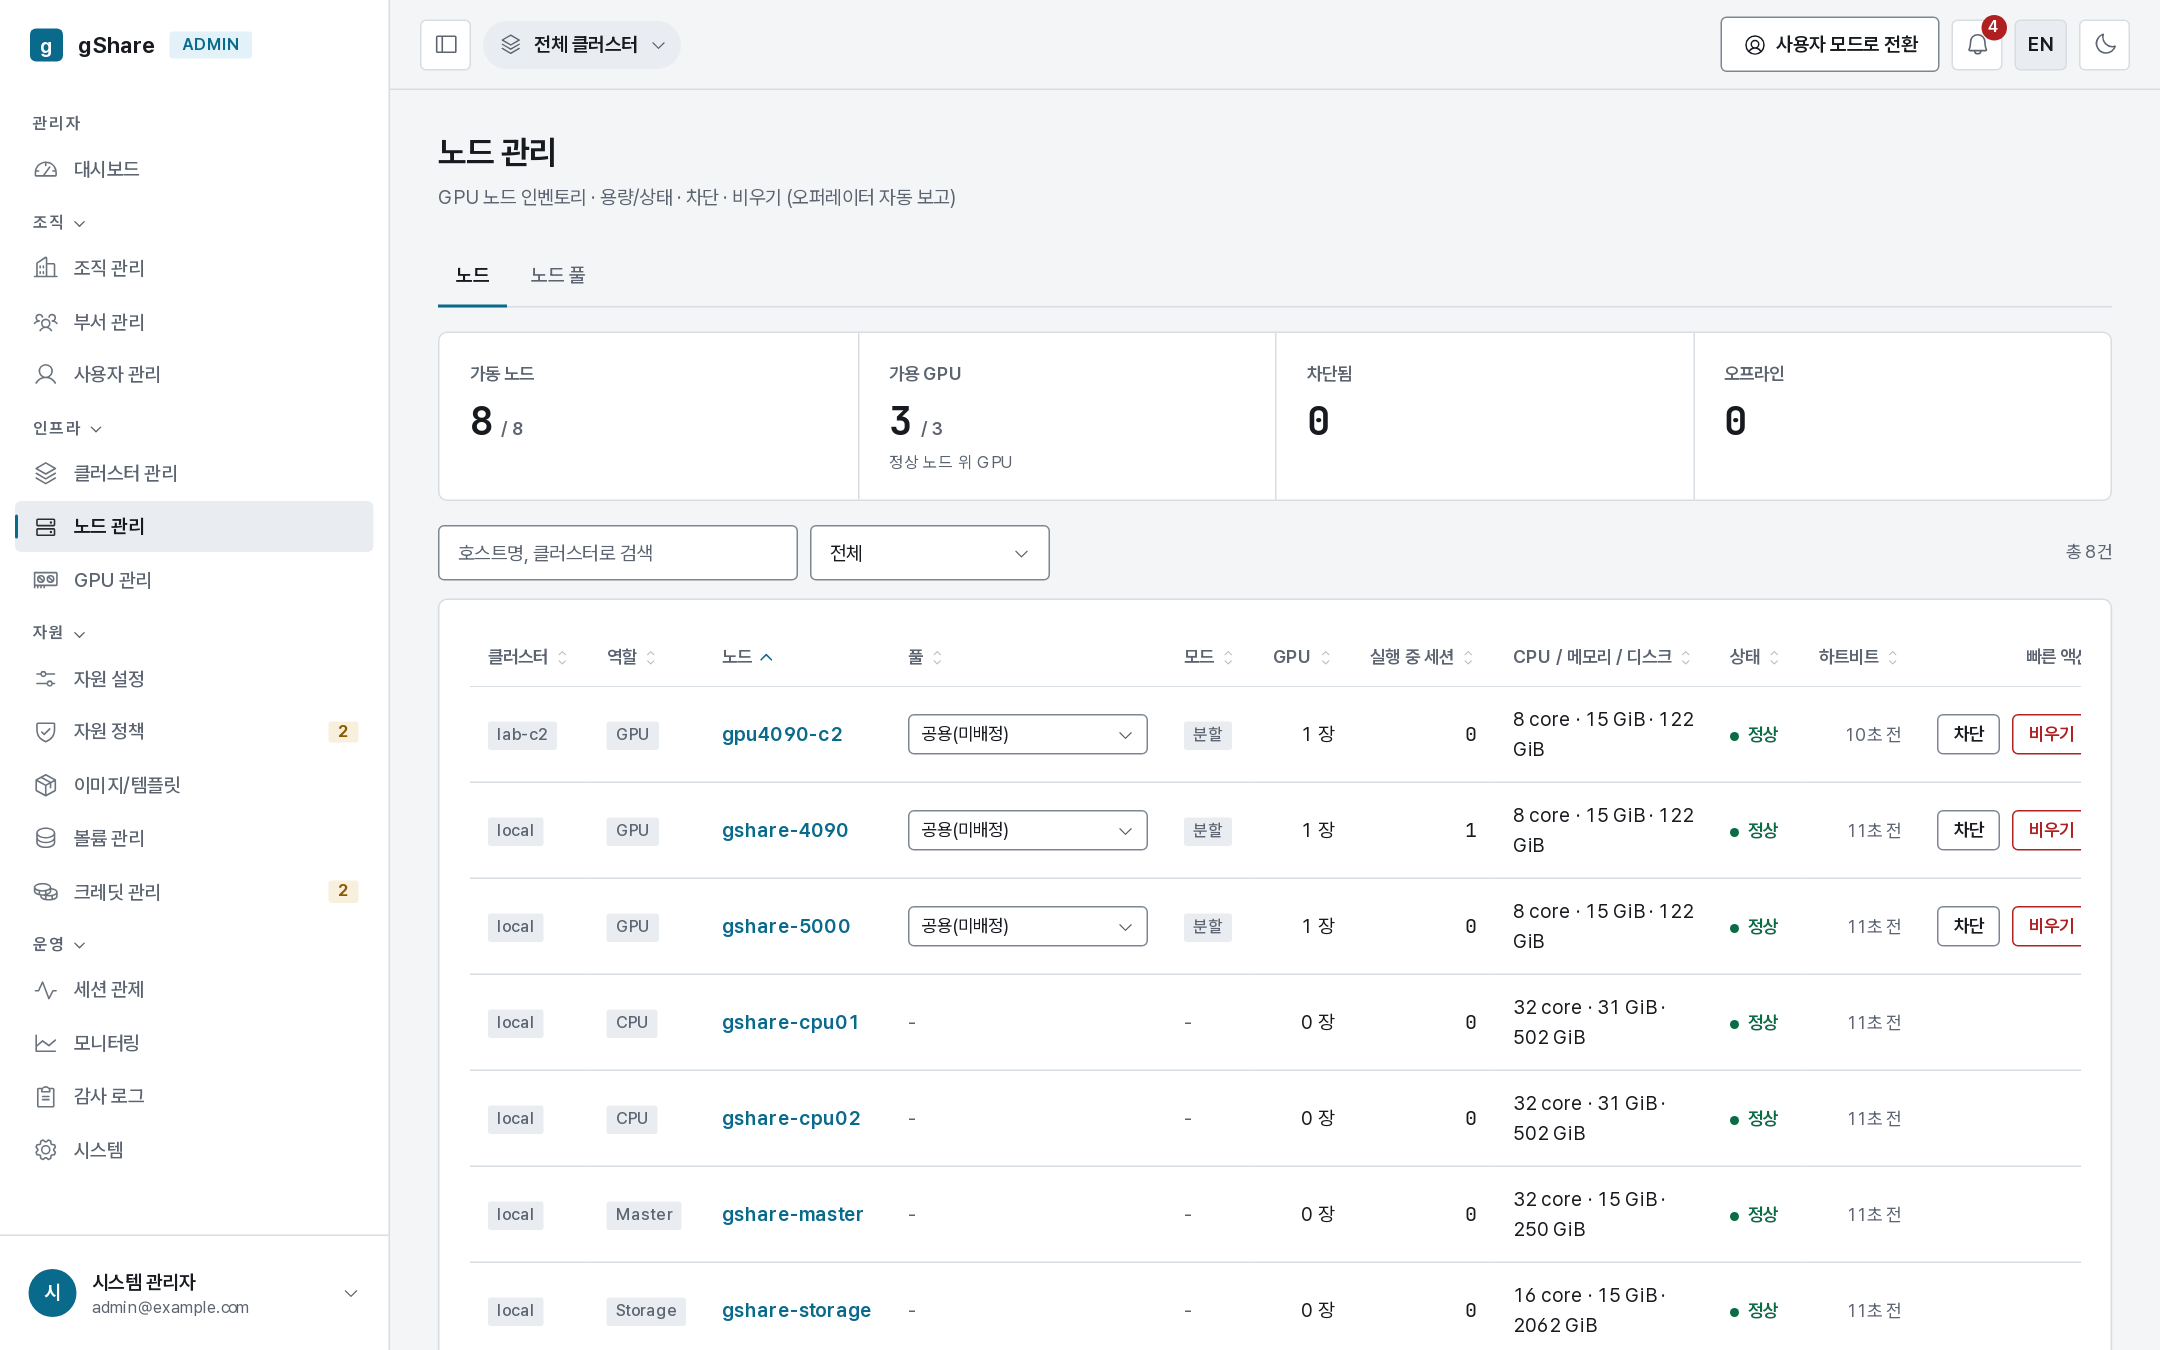
| 열 | 의미 |
|---|---|
| 클러스터 / 역할 | 노드가 속한 클러스터 및 역할(GPU / CPU / 마스터 / 스토리지) |
| 노드 | 호스트명 (클릭 시 장착된 GPU 카드 목록 화면으로 이동합니다). |
| 풀 | 속한 노드 풀 (해당 위치에서 즉시 변경할 수 있습니다). |
| 모드 | 노드 라벨 설정에 따른 분할(Shared) 또는 전용(Dedicated) 모드 |
| GPU / 실행 중 세션 | 장착된 GPU 카드 수 및 해당 노드에서 실행 중인 세션 정보 |
| CPU / 메모리 / 디스크 | 호스트의 전체 자원 용량 |
| 상태 | 정상(Ready), 사용 중, 차단(Cordoned), 오프라인 |
| 하트비트 | 마지막으로 노드 상태가 보고된 후 경과한 시간 |
노드는 콘솔에서 수동으로 등록하지 않습니다. 오퍼레이터의 인벤토리 컨트롤러가 노드 정보를 수집하여 보고하면, 제어 플레인(Control Plane)이 (클러스터, 호스트명) 조합을 기준으로 업서트(Upsert) 처리합니다. 신규 노드가 클러스터에 참여(Join)하면 1분 이내에 자동으로 목록에 등록됩니다.
생존 판정
api.nodeStaleSec(기본 5분) 동안 보고가 수신되지 않는 노드는 자동으로 오프라인 상태로 전환되며, 보고가 재개되면 정상 상태로 복구됩니다. 오퍼레이터가 노드 자체의 Ready 상태를 지속해서 보고하므로, kubelet 서비스가 중단된 노드는 타임아웃을 기다리지 않고 즉시 오프라인으로 전환됩니다.
노드가 오프라인 처리되면 실행 중인 세션은 종료 및 정산되며(node_offline), 일시정지 상태의 세션은 다른 노드에서 재개될 수 있도록 유지됩니다. 상태가 전환될 때마다 모든 시스템 관리자에게 알림이 발송되므로, 관제 화면을 상시 주시하지 않아도 노드 이탈 여부를 파악할 수 있습니다.
차단(cordon)
차단 기능은 해당 노드로의 신규 세션 배치를 중지합니다. 이미 실행 중인 세션은 영향 없이 유지됩니다. 차단 설정은 약 15초 이내에 Kubernetes 노드 설정에도 동기화되어 반영되므로, kube-scheduler가 스케줄링하는 CPU 세션의 재배치 역시 차단됩니다.
노드 점검이나 비우기 작업을 진행하기 전에 먼저 차단 설정을 적용하세요.
비우기(drain)
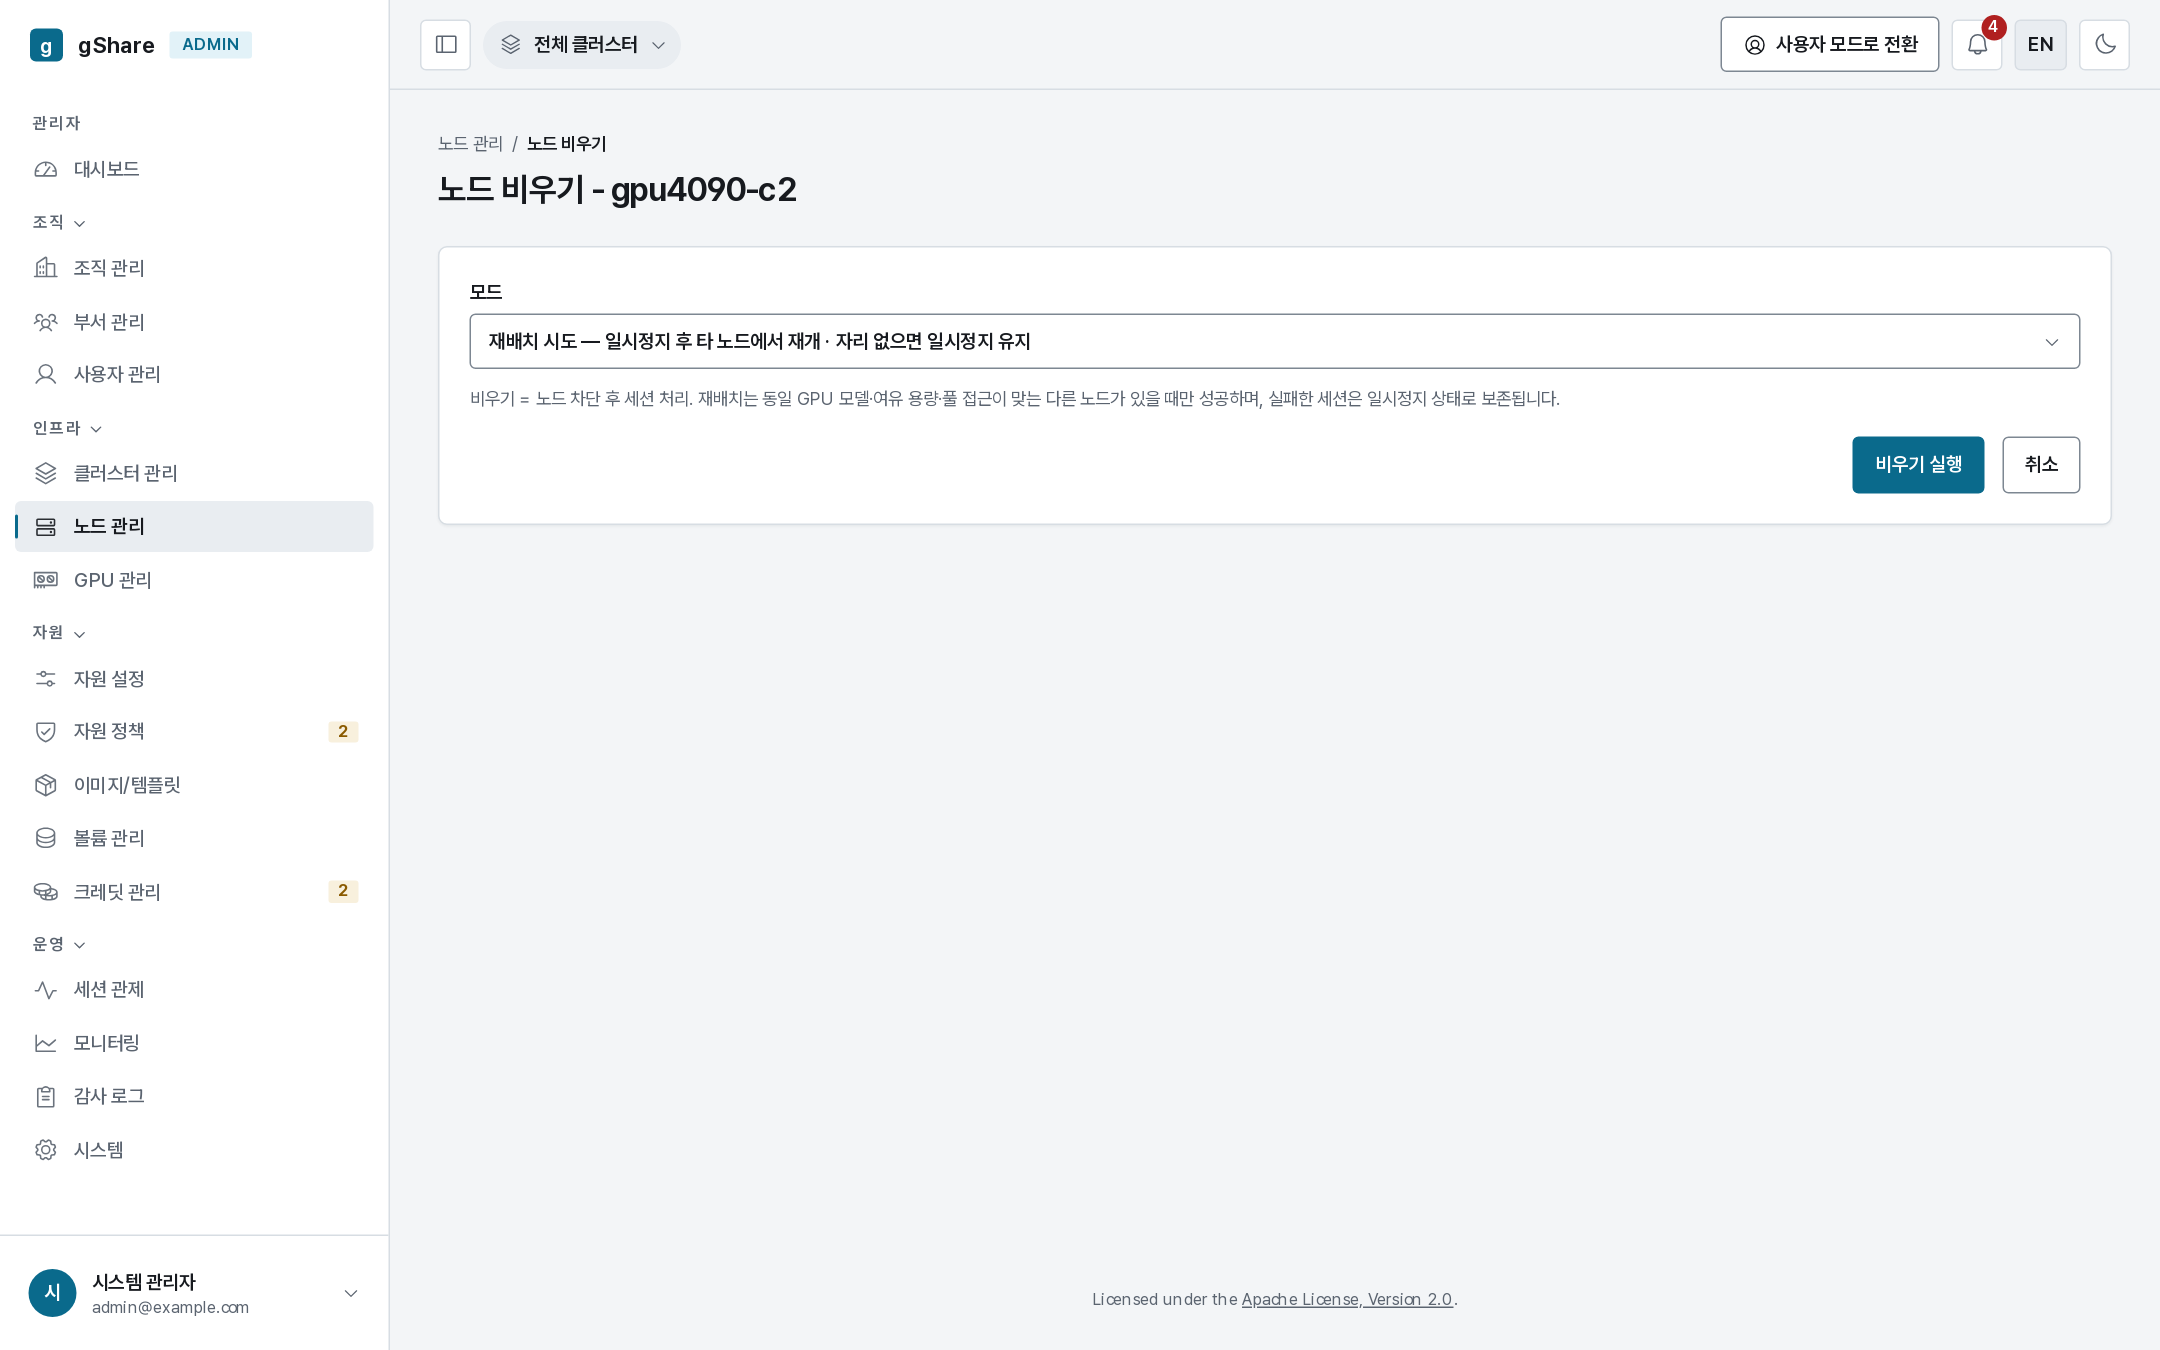
비우기 기능은 노드를 차단한 후 해당 노드에서 실행 중인 세션들을 정리하는 작업입니다. 두 가지 방식을 제공합니다.
| 방식 | 세션별 처리 동작 |
|---|---|
| 재배치(기본값) | 콜드 일시정지(Cold Pause) 처리 후 다른 노드에서 즉시 재개합니다. GPU 세션은 동일한 모델의 여유 자원과 풀 접근 권한이 있는 카드가 필요하며, CPU 세션은 여유 있는 CPU 노드가 필요합니다. 즉시 재배치할 노드가 없는 세션은 대기 보관 상태로 전환됩니다. 대기열에서 일시정지 상태를 유지하다가 여유 자원이 확보되면(다른 세션 종료 또는 노드 차단 해제 시) 큐 티커(Queue Ticker)가 해당 세션을 재개합니다. |
| 강제 종료 | 모든 세션을 관리자 강제 종료와 동일하게 정산 및 종료 처리합니다. |
특별한 사유가 없다면 재배치 방식을 권장합니다. 진행 중인 작업 상태가 보존되고, 사용자 입장에서는 강제 종료가 아닌 일시정지 후 재개로 처리되며, 일시정지 기간에는 요금이 부과되지 않습니다.
비우기 실행 전 확인 화면에서 대상 노드에서 실행 중인 세션, 소유자, 점유 중인 GPU 카드 정보를 미리 보여줍니다.
노드 삭제
삭제 메뉴는 오프라인 상태인 노드에만 표시됩니다. 오퍼레이터가 상태를 보고 중인 활성 노드는 삭제하더라도 다음 인벤토리 수집 주기에 다시 등록되기 때문입니다.
활성화된 자원 할당이나 종료되지 않은 세션이 남아 있는 경우 삭제 요청이 거부됩니다(node_busy). 노드 및 장착된 GPU 카드 이력을 삭제하더라도 과금 이력은 안전하게 보존됩니다. 과거 자원 할당 기록은 gpu_uuid 정보를 유지한 채, 삭제된 카드 엔티티와 분리되어 보관됩니다.
노드에 장착된 마지막 GPU 카드를 삭제할 경우 해당 카드가 속해 있던 전용 풀이 빈 상태가 됩니다. 새로운 노드를 해당 풀에 배정하거나 더 이상 사용하지 않는 풀을 삭제하세요.
인프라 차원의 물리적/논리적 노드 작업 절차(kubectl drain, kubeadm reset, 노드 라벨 변경 등)는 클러스터 구축 문서를 참조하세요.