지표와 사용률
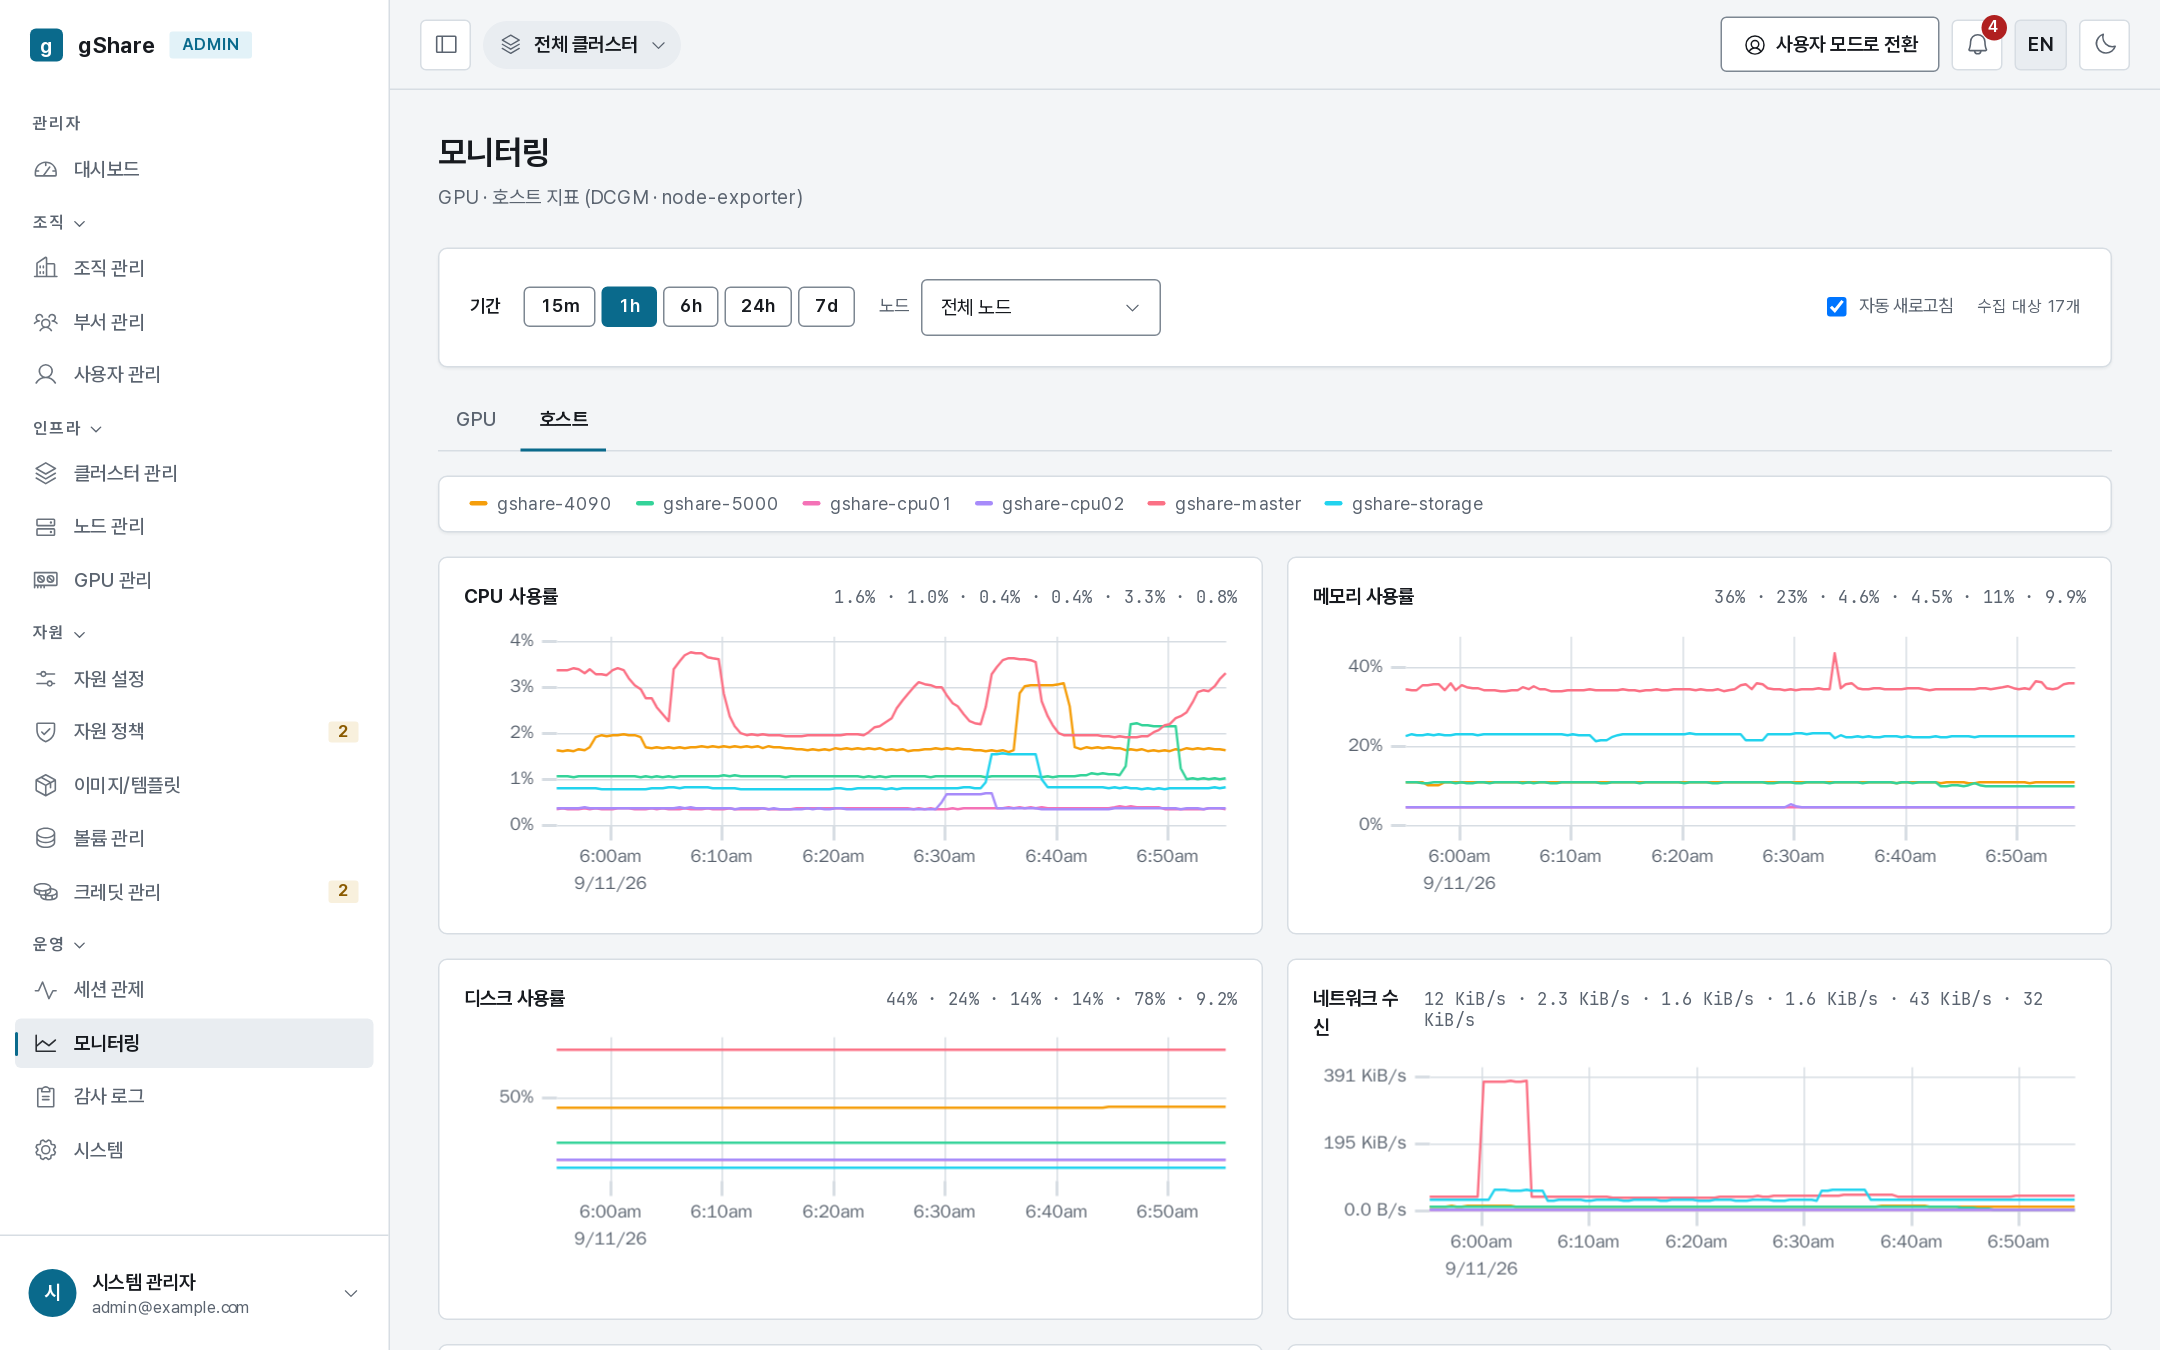
운영 → 모니터링 메뉴는 DCGM, node-exporter, Prometheus를 통해 수집된 실제 하드웨어의 작동 상태를 시각화하여 제공합니다. 이는 콘솔 내 다른 화면에서 제공하는 자원 할당 수치와 대조하여 모니터링하는 데 활용됩니다.
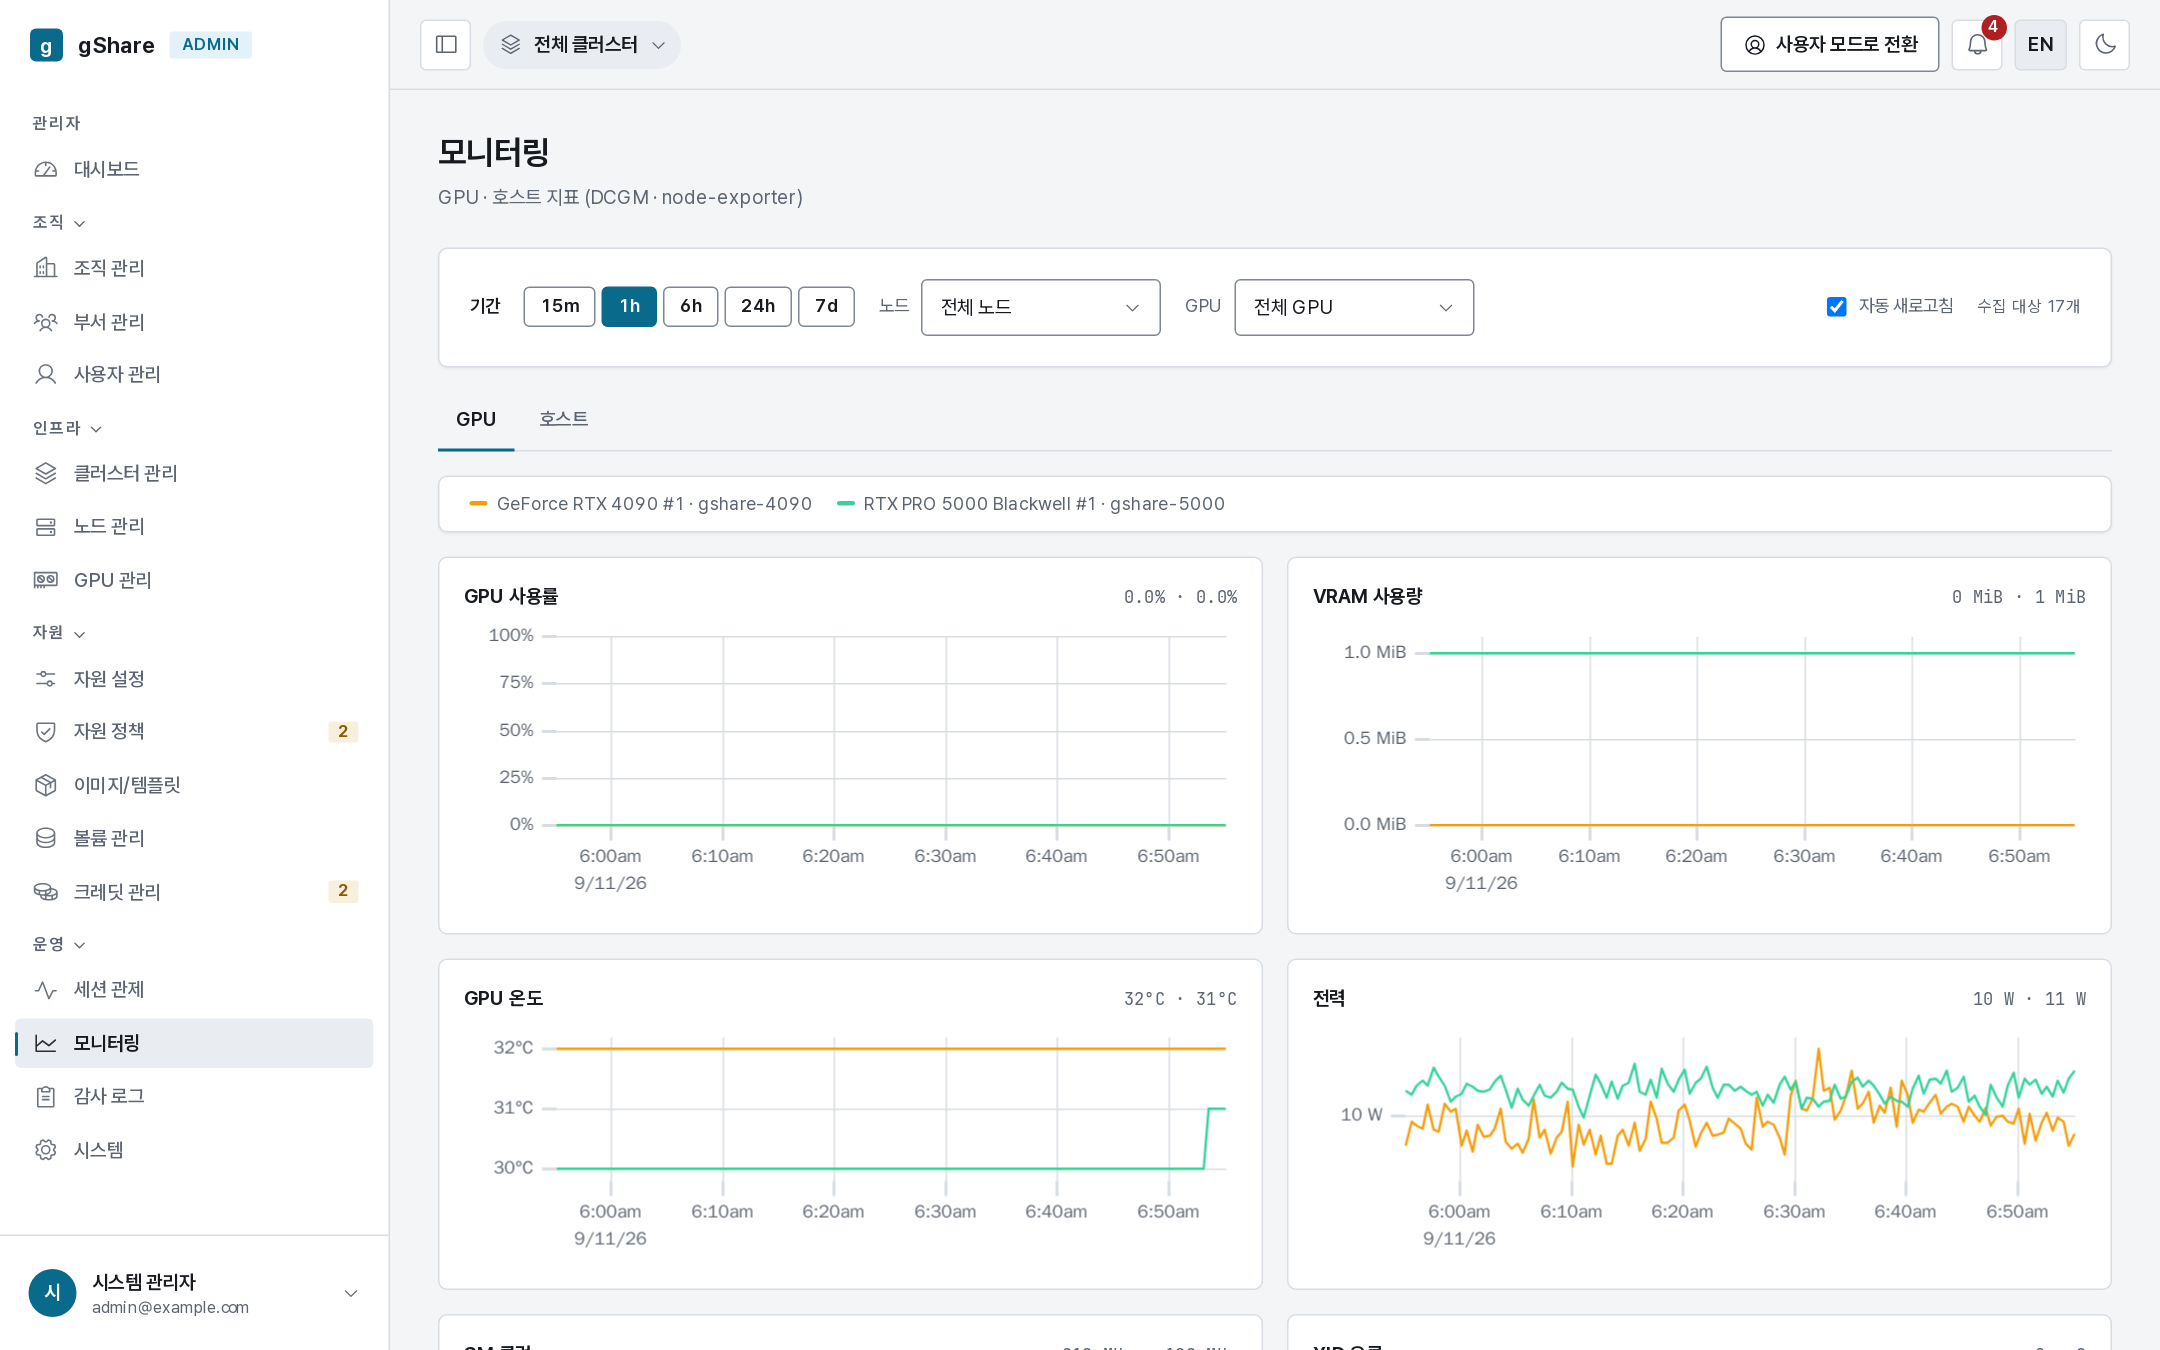
| 탭 | 내용 |
|---|---|
| GPU | 노드 및 카드별 사용률, VRAM 사용량, 온도, 전력 소비량 |
| 호스트 | 노드별 CPU, 메모리, 디스크, 네트워크 사용량 |
상단 영역에서 조회 기간 선택 및 자동 새로고침 모드를 설정할 수 있으며, 노드 필터를 통해 특정 노드의 지표만 선택하여 확인할 수 있습니다.
할당량 대비 실제 사용량
차트 하단의 표는 할당량과 실제 사용량을 대조하여 분석할 수 있는 중요한 지표를 제공합니다.
그래프는 GPU 카드의 실시간 작동 상태를 나타내며, 표는 제어 플레인이 사용자 및 세션에 할당한 이력 기록입니다.
분할(Shared) 모드로 설정된 GPU 카드는 여러 세션이 자원을 공유하여 사용하므로, 그래프 수치만으로는 특정 세션을 식별하기 어렵습니다. 따라서 두 정보를 함께 종합적으로 검토해야 합니다. 주요 점검 패턴은 다음과 같습니다.
| 할당량 | 사용률 | 대처 및 점검 방안 |
|---|---|---|
| 높음 | 높음 | 자원이 실제로 포화 상태입니다. 하드웨어를 증설하거나 쿼터 제한을 강화하세요. |
| 높음 | 낮음 | 자원이 미사용 상태로 예약되어 있습니다. 유휴 제한 시간을 줄이고 더 작은 자원 티어를 제공하세요. |
| 낮음 | 높음 | 일부 소수 사용자가 전용 카드에서 고부하 작업을 수행 중입니다. 단가 설정이나 풀 정책을 검토하세요. |
화면이 비어 있는 경우
모니터링 지표를 표시하기 위해서는 모니터링 스택이 수집 환경에 구비되어 있어야 합니다. make deploy-monitoring 명령을 실행하면 DCGM, node-exporter, kube-state-metrics 익스포터와 함께 Prometheus가 설치됩니다.
모니터링 스택이 구축되지 않은 경우 콘솔에 메트릭 백엔드 연결 불가 메시지가 표시됩니다. 무엇보다 operator.hamiMonitorUrl 또는 operator.prometheusUrl 설정을 지정하지 않으면 유휴 리퍼(Idle Reaper)가 참조할 사용률 수집 데이터 소스를 확보할 수 없게 됩니다.
각 익스포터(Exporter)가 제공하는 세부 수집 항목 및 연동에 대한 자세한 내용은 운영 → 관측 문서를 참조하세요.
Prometheus 서비스는 클러스터 외부로 직접 노출되지 않습니다. 콘솔은 gshare-api를 거쳐 메트릭을 조회하며, API 레벨에서 실행 가능한 쿼리를 화이트리스트 기반으로 제한하고 시스템 관리자 권한 검증을 검사합니다.